通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-06-07 图像表征 · VFM · JEPA · 视频预训练
CVPR 2026 Day 3 · P2 · 2026-06-07

CORE:它和通用视觉自监督的关系在于:用 object masks 引导 LVLM token merging,说明高层 object-centric 表征比纯几何压缩更稳

中高相关;详见方法、贡献和实验边界。

编号2511.14072 优先级P2 类别CVPR 2026 Day 3 会议arXiv + CVPR 2026 Day 3 方法用 object masks 引导 LVLM token merging,说明高层 object-centric 表征比纯几何压缩更稳 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:用 object masks 引导 LVLM token merging,说明高层 object-centric 表征比纯几何压缩更稳。 中高相关;详见方法、贡献和实验边界。

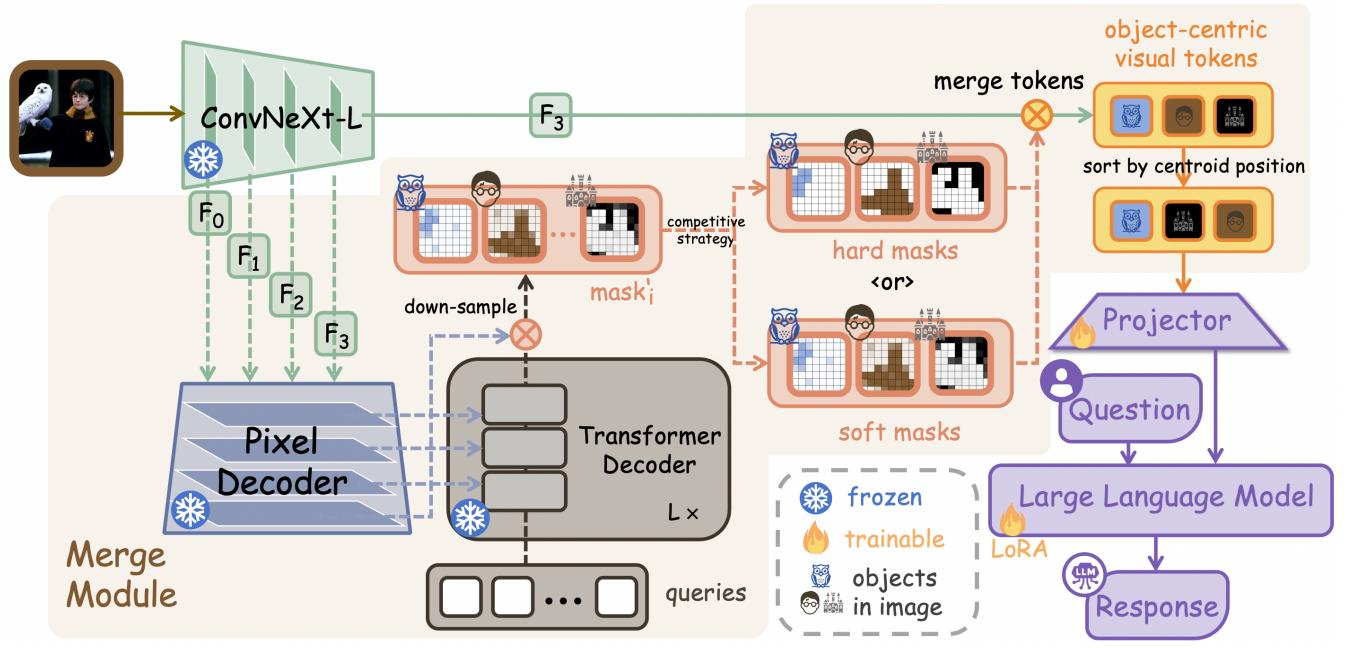
Figureure 2 · Overview of CORE
Figureure 2 · Overview of COREFigure 2. Overview of CORE. Our framework consists of two key pathways. The primary data flow, indicated by solid lines, shows how compact object-centric representations are generated and processed by the language decoder. This process is informed by the auxiliary segmentation head, shown with dashed lines, which produces the object masks that guide the token merging. The icon in the top-left corner of each mask denotes a different object in the image.这张图概括 CORE 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。
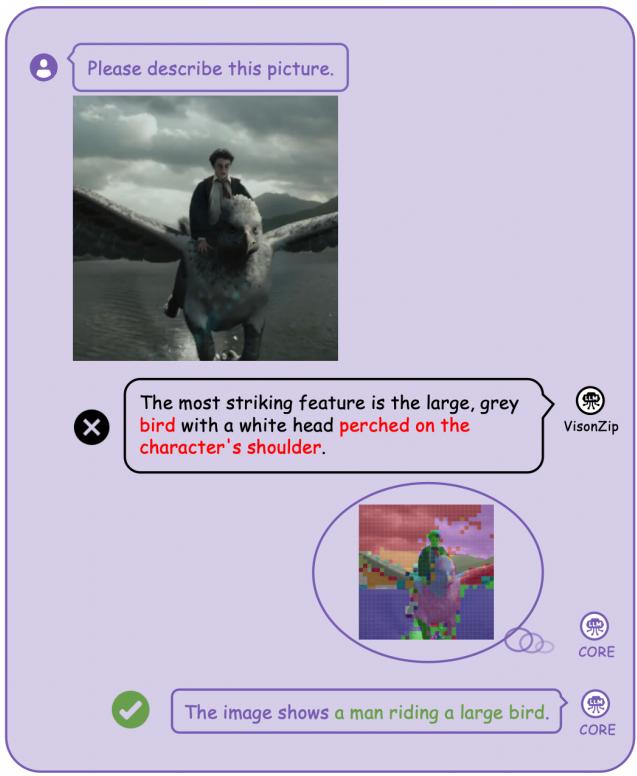
Figure S5
Figure S5Figure S5. Comparison on Objects’ Positional Relationship Detection. Incorrect and correct model responses are highlighted in red and green, respectively.这张图/表用于判断 CORE 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
核心问题

它和通用视觉自监督的关系在于:用 object masks 引导 LVLM token merging,说明高层 object-centric 表征比纯几何压缩更稳。

方法拆解

用 object masks 引导 LVLM token merging,说明高层 object-centric 表征比纯几何压缩更稳

主要贡献

中高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。