通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-06-14 图像表征 · VFM · JEPA · 视频预训练
arXiv 更新 (v3) · P0 · 2026-06-14

V-JEPA 2.1:它和通用视觉自监督的关系在于:V-JEPA 系列更新到 dense image/video features,把 masked predictive loss、深层自监督和图像/视频 tokenizer 统一到同一表征路...

高相关;详见方法、贡献和实验边界。

编号2603.14482 优先级P0 类别arXiv 更新 (v3) 会议arXiv 更新 (v3) 方法V-JEPA 系列更新到 dense image/video features,把 masked predictive loss、深层自监督和图像/视频 tokenizer 统一到同一表征路线 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:V-JEPA 系列更新到 dense image/video features,把 masked predictive loss、深层自监督和图像/视频 tokenizer 统一到同一表征路... 高相关;详见方法、贡献和实验边界。

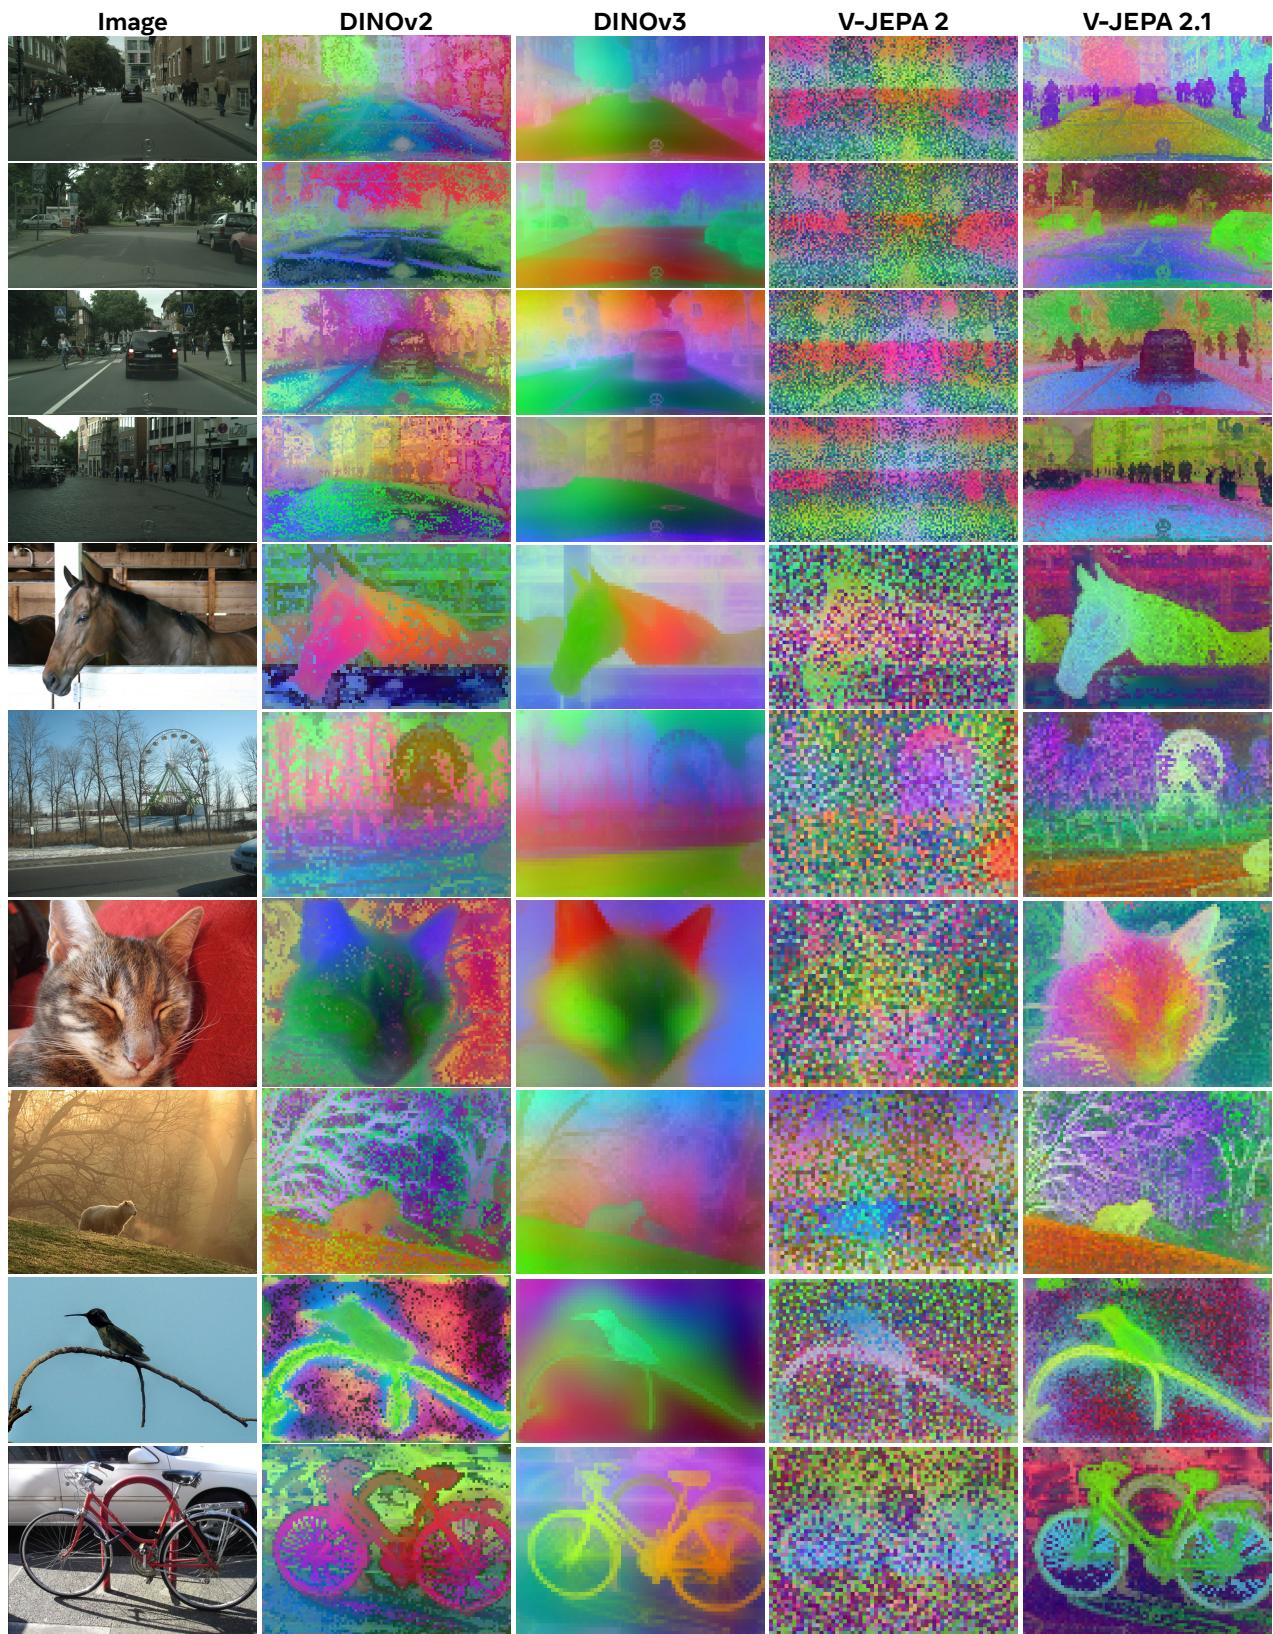
Figureure 14 · Comparison of dense features produced by different SSL methods on a si
Figureure 14 · Comparison of dense features produced by different SSL methods on a siFigure 14 Comparison of dense features produced by different SSL methods on a single image. We compare DINOv2 ViT-g (Oquab et al., 2023), DINOv3 ViT-H+ (Siméoni et al., 2025) and V-JEPA 2 ViT-g (Assran et al., 2025) against V-JEPA 2.1 ViT-G. Images are resized so that their shorter side is set to 1024 pixels, after which they are processed using the 2D convolution image tokenizer.这张图/表用于判断 V-JEPA 2.1 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
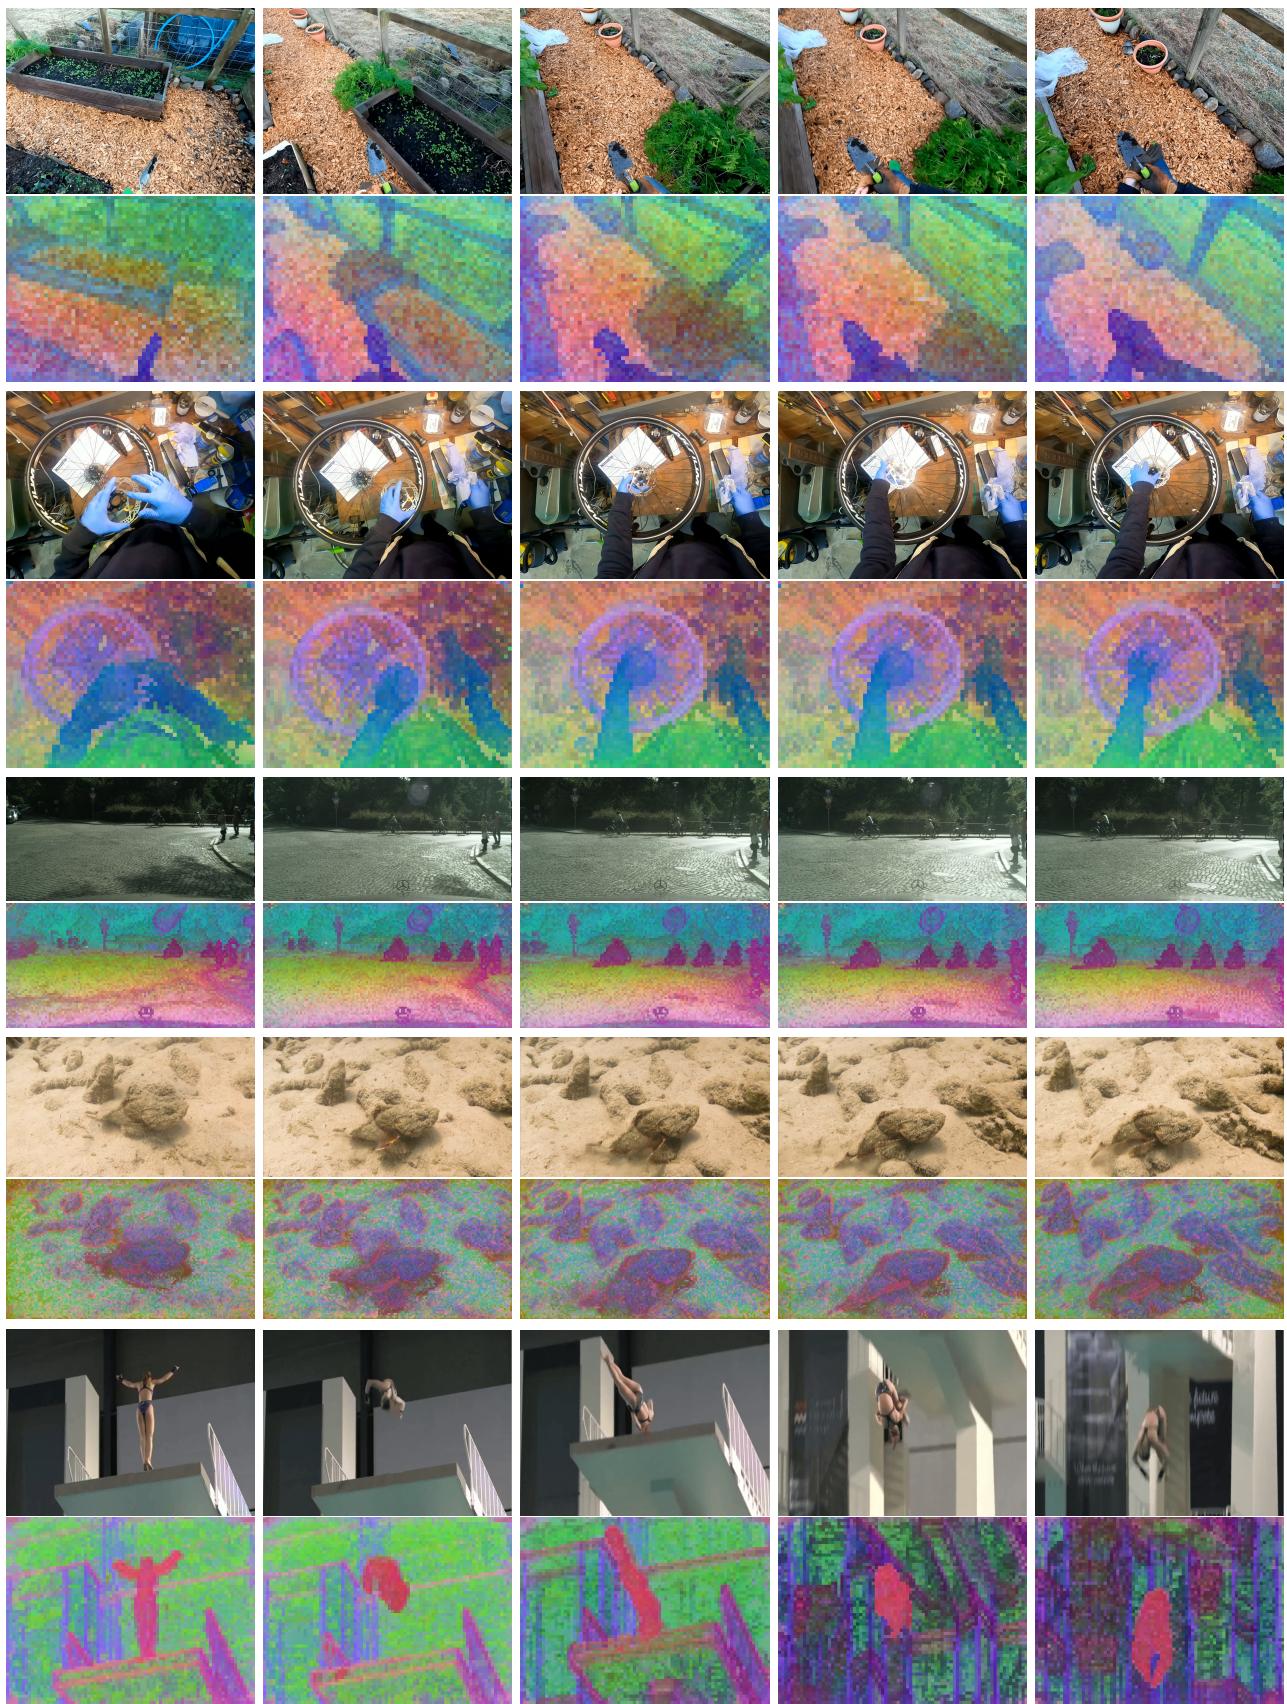
Figureure 15 · V-JEPA 2.1 unlocks dense features from video
Figureure 15 · V-JEPA 2.1 unlocks dense features from videoFigure 15 V-JEPA 2.1 unlocks dense features from video. Qualitative results on Ego4D (1080px), Cityscapes (1080px), Diving48 (768px), and MOCA (768px) illustrate the strong temporal consistency of the dense features produced by our ViT-G model, particularly on dynamic objects. Since we process entire video sequences, we employ the 3D convolutional video tokenizer.这张图/表用于判断 V-JEPA 2.1 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
核心问题

它和通用视觉自监督的关系在于:V-JEPA 系列更新到 dense image/video features,把 masked predictive loss、深层自监督和图像/视频 tokenizer 统一到同一表征路线。

方法拆解

V-JEPA 系列更新到 dense image/video features,把 masked predictive loss、深层自监督和图像/视频 tokenizer 统一到同一表征路线

主要贡献

高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。