通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-06-05 图像表征 · VFM · JEPA · 视频预训练
Visual SSL / representation · P1 · 2026-06-05

ChannelTok:它和通用视觉自监督的关系在于:把 latent channel 当视觉 token,训练时随机丢尾通道形成按语义重要性排序的可变长视觉 tokenizer

高相关;详见方法、贡献和实验边界。

编号2606.04461 优先级P1 类别Visual SSL / representation 会议arXiv 方法把 latent channel 当视觉 token,训练时随机丢尾通道形成按语义重要性排序的可变长视觉 tokenizer 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:把 latent channel 当视觉 token,训练时随机丢尾通道形成按语义重要性排序的可变长视觉 tokenizer。 高相关;详见方法、贡献和实验边界。

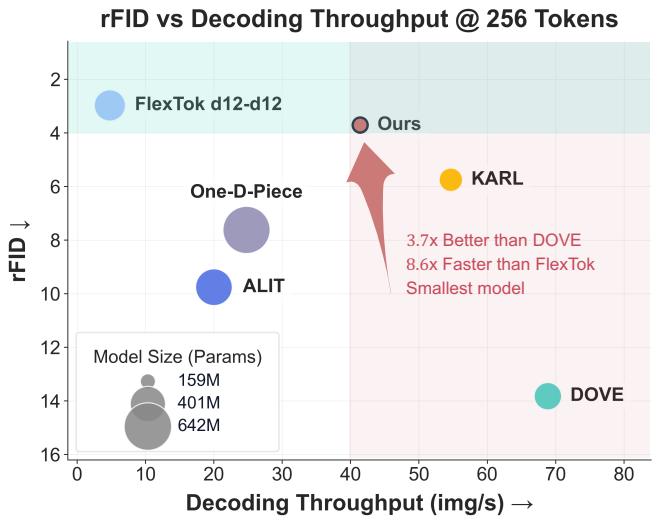
Figureure 1 · Quality-efficiency comparison
Figureure 1 · Quality-efficiency comparisonFigure 1. Quality-efficiency comparison. Reconstruction fidelity (rFID), decoding throughput, and model size across recent tokenizers. Our method achieves state-of-the-art rFID while being the smallest and among the fastest decoders.这张图/表用于判断 ChannelTok 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
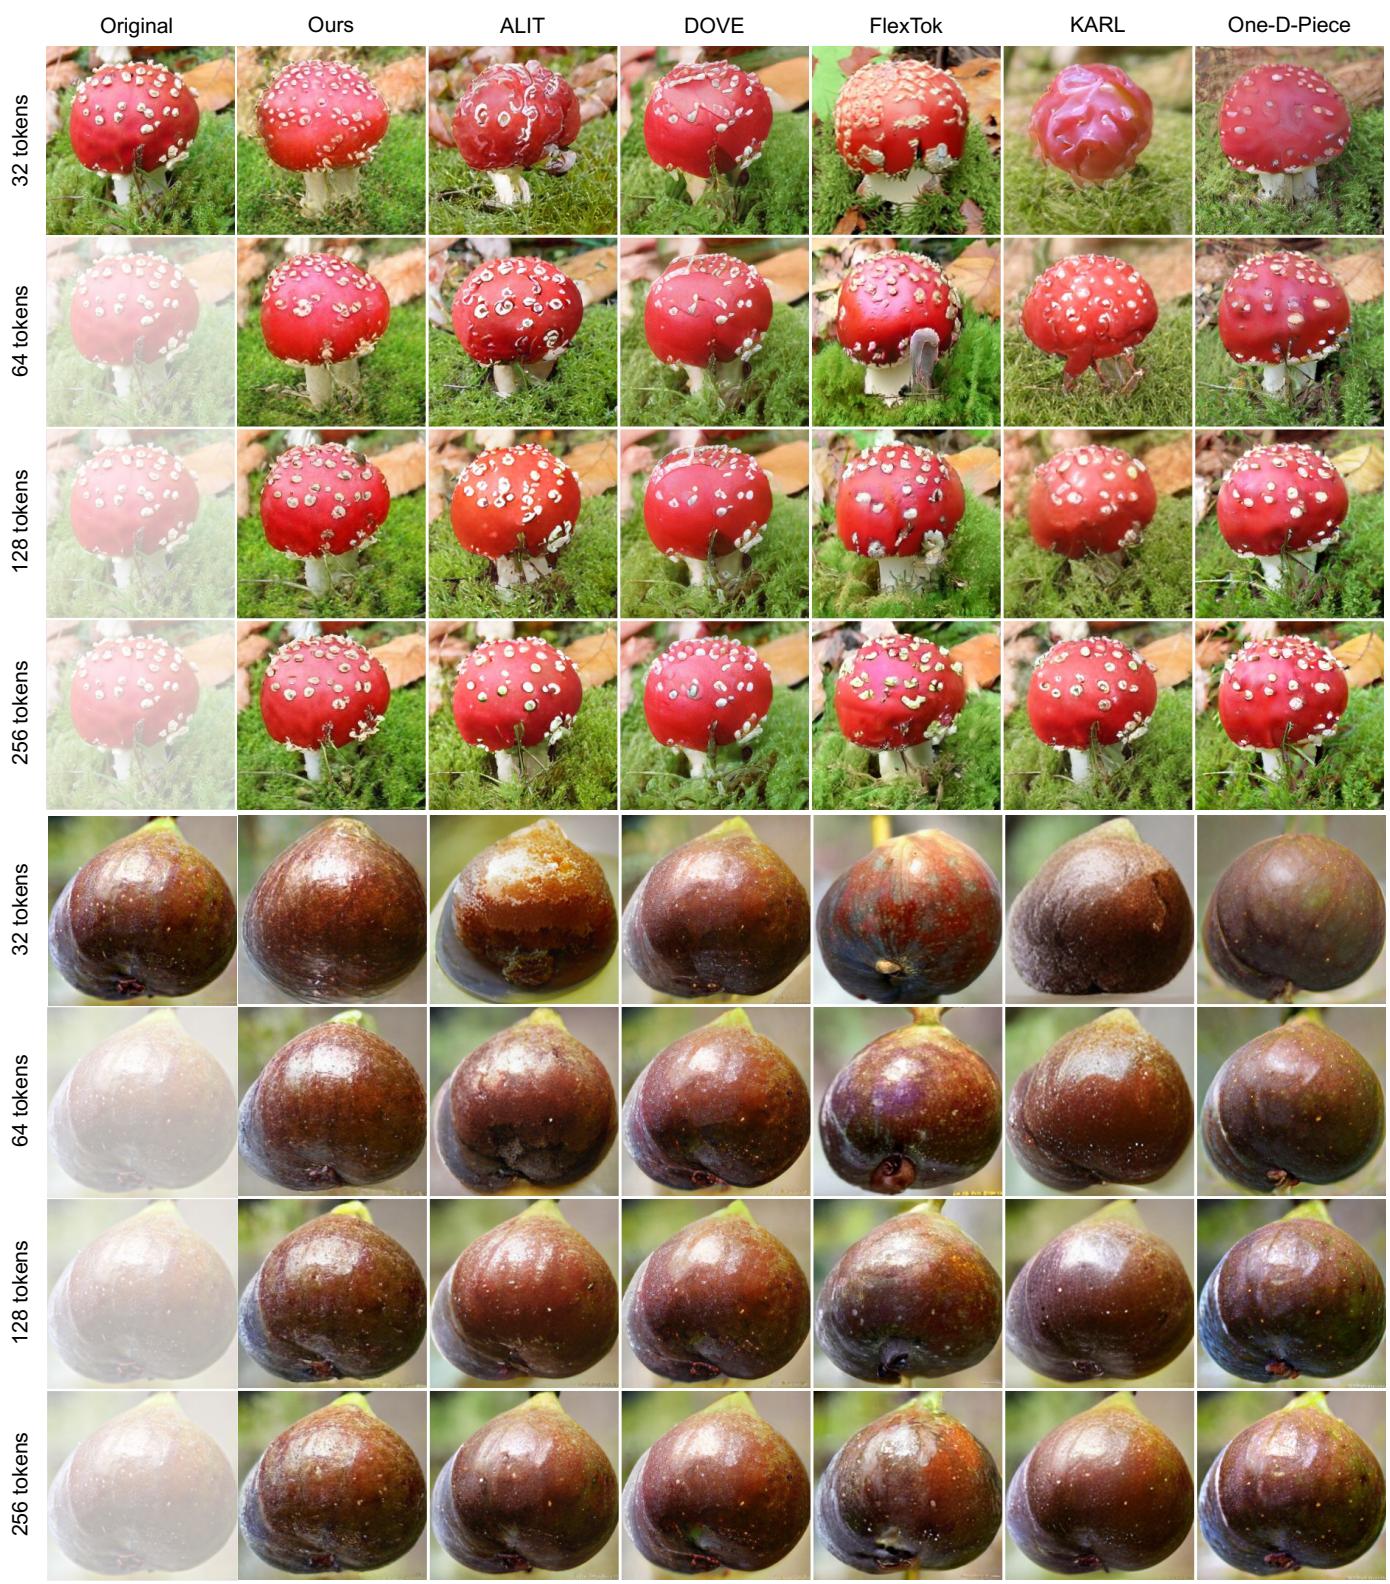
Figureure 15 · Qualitative comparison on images with varied textures
Figureure 15 · Qualitative comparison on images with varied texturesFigure 15. Qualitative comparison on images with varied textures. Top: A red mushroom with white spots against a mossy background, where our method preserves fine surface detail and color fidelity even at low token budgets. Bottom: A dark round fruit, where competing methods introduce color artifacts and lose surface sheen at low tokens, while ours maintains perceptual consistency across all budgets.这张图/表用于判断 ChannelTok 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
核心问题

它和通用视觉自监督的关系在于:把 latent channel 当视觉 token,训练时随机丢尾通道形成按语义重要性排序的可变长视觉 tokenizer。

方法拆解

把 latent channel 当视觉 token,训练时随机丢尾通道形成按语义重要性排序的可变长视觉 tokenizer

主要贡献

高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。