通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-06-05 图像表征 · VFM · JEPA · 视频预训练
CVPR 2026 · P2 · 2026-06-05

Scene-Centric Unsupervised Video Panoptic Segmentation:它和通用视觉自监督的关系在于:VideoCUPS 用无监督深度、运动和视觉 cues 生成时序一致伪标签,是视频无监督场景理解的重要扩展

中高相关;详见方法、贡献和实验边界。

编号2606.04925 优先级P2 类别CVPR 2026 会议arXiv + CVPR 2026 方法VideoCUPS 用无监督深度、运动和视觉 cues 生成时序一致伪标签,是视频无监督场景理解的重要扩展 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:VideoCUPS 用无监督深度、运动和视觉 cues 生成时序一致伪标签,是视频无监督场景理解的重要扩展。 中高相关;详见方法、贡献和实验边界。

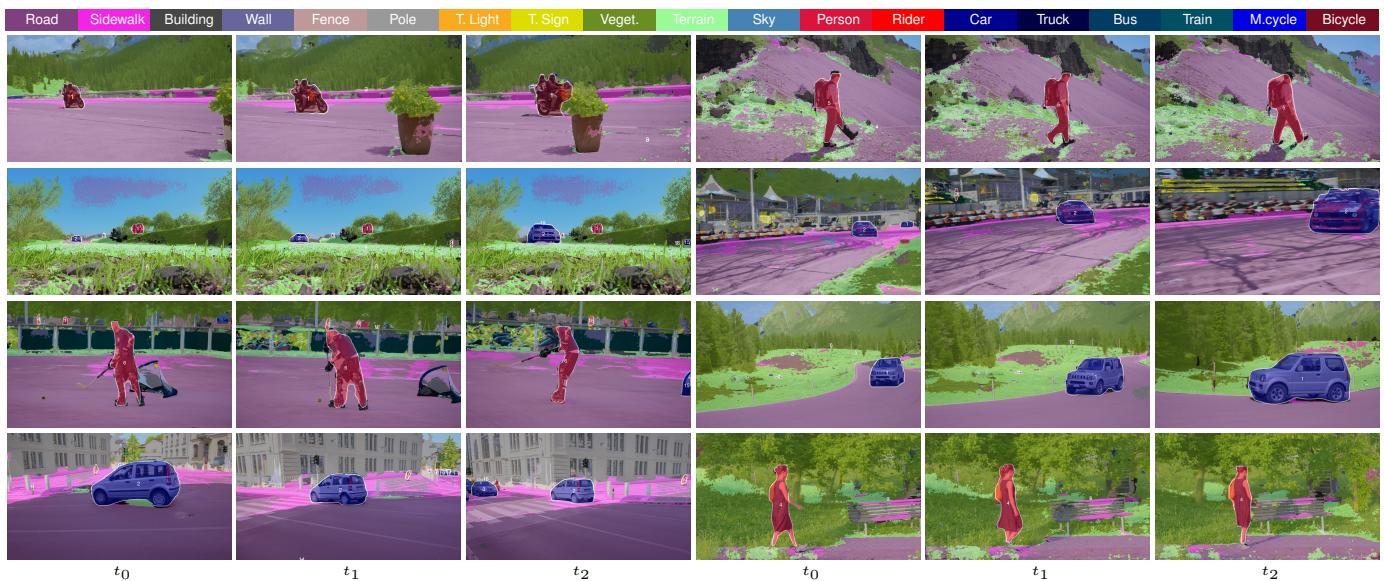
Figureure 10 · Qualitative unsupervised VPS examples on DAVIS [132]
Figureure 10 · Qualitative unsupervised VPS examples on DAVIS [132]Figure 10. Qualitative unsupervised VPS examples on DAVIS [132]. We provide qualitative samples for VideoCUPS inference on DAVIS videos using the Cityscapes-VPS class assignments for visualization purposes. VideoCUPS generalizes to the unseen dataset and even to unseen semantic concepts.这张可视化用来解释 Scene-Centric Unsupervised Video Panoptic Segmentation 学到的中间表征或对齐关系。重点看它是否支持正文里的机制判断。
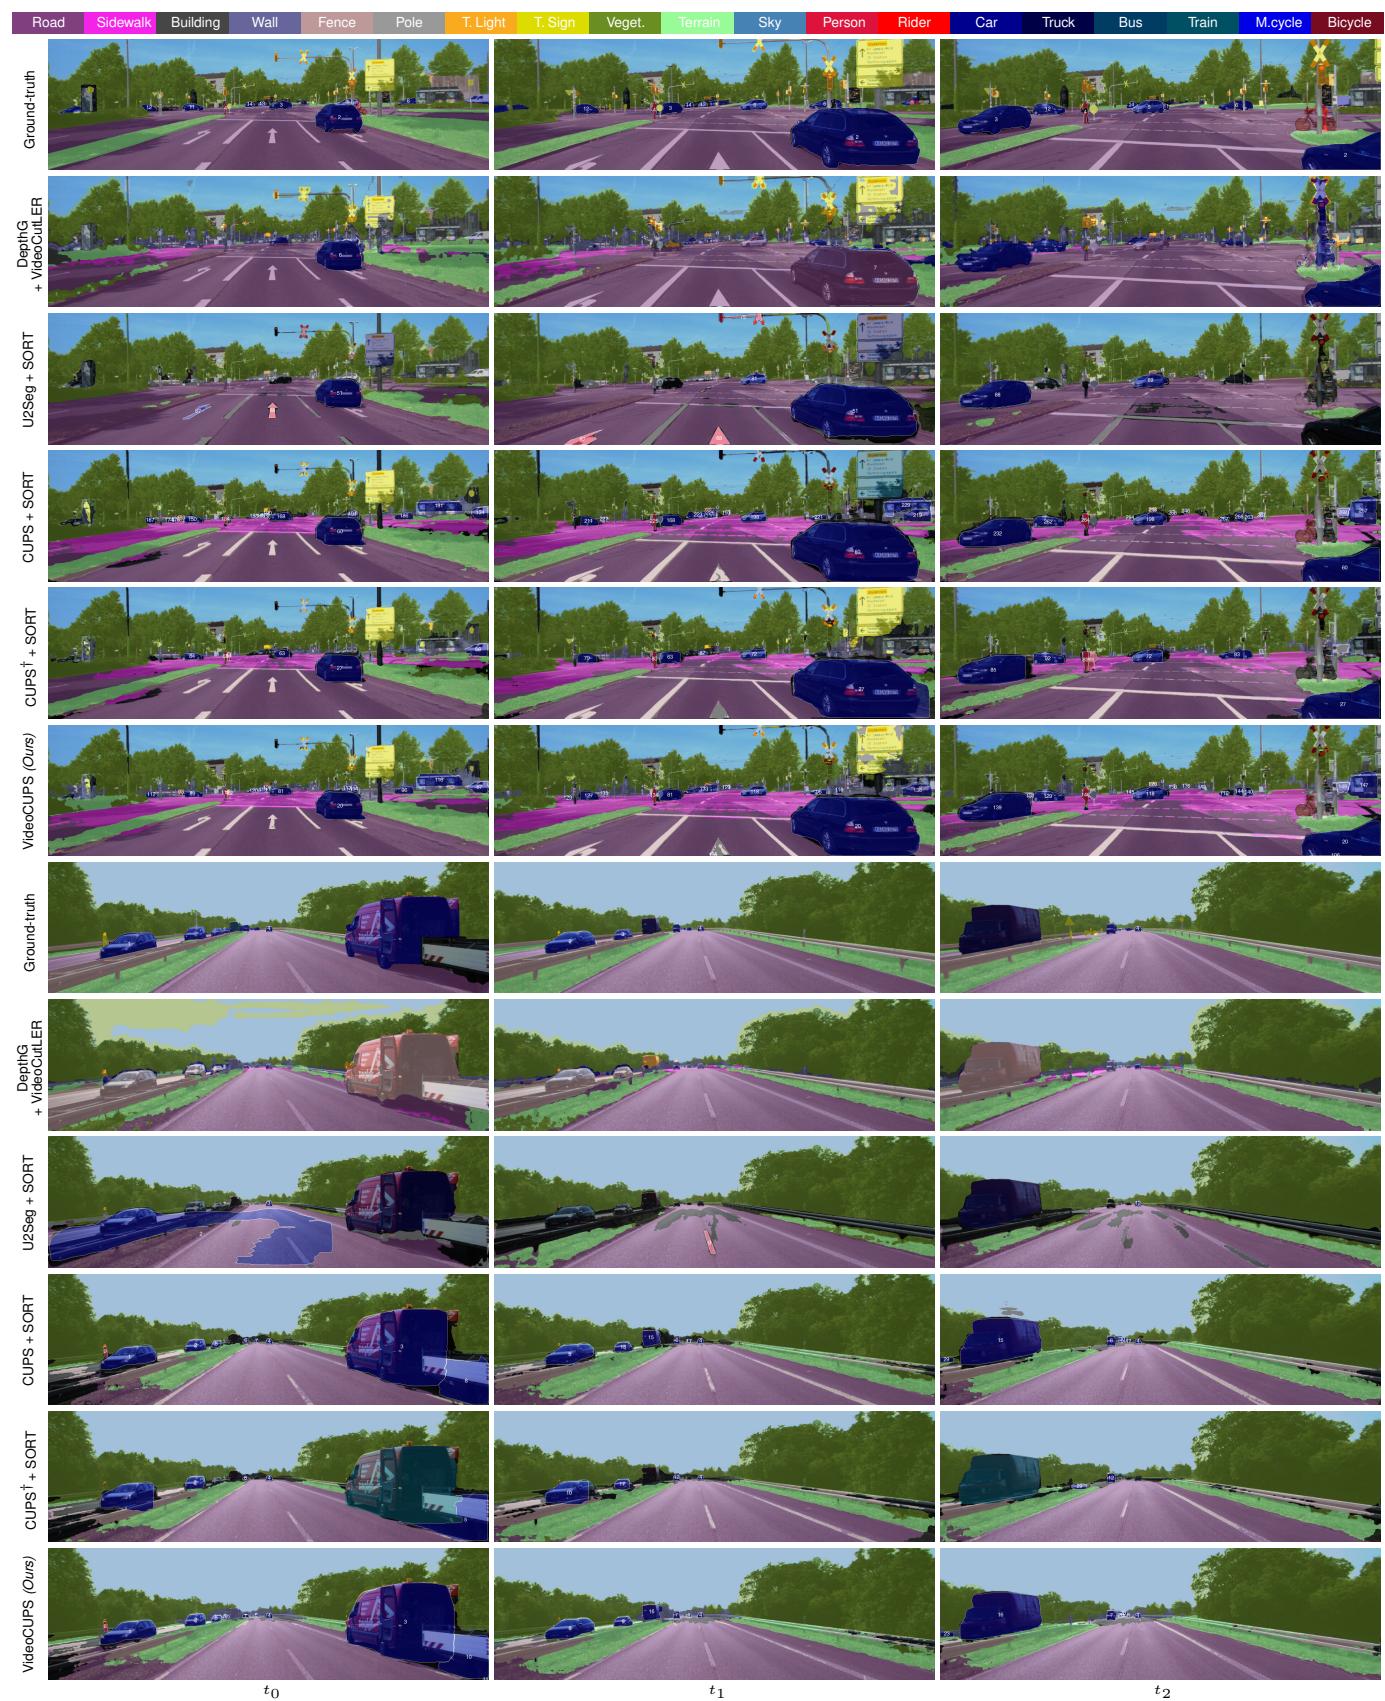
Figureure 7 · KITTI-STEP—Qualitative unsupervised VPS examples
Figureure 7 · KITTI-STEP—Qualitative unsupervised VPS examplesFigure 7. KITTI-STEP—Qualitative unsupervised VPS examples. We compare our proposed method VideoCUPS to the proposed baselines DepthG [91] + VideoCutLER [110], U2Seg [81] + SORT, CUPS [41] + SORT [9], and CUPS† [41] + SORT [9] on KITTI-STEP [114] val.这张图来自论文 PDF 的结构化抽取。当前用于辅助理解 Scene-Centric Unsupervised Video Panoptic Segmentation 的方法或实验,请结合正文精读段落一起看。
核心问题

它和通用视觉自监督的关系在于:VideoCUPS 用无监督深度、运动和视觉 cues 生成时序一致伪标签,是视频无监督场景理解的重要扩展。

方法拆解

VideoCUPS 用无监督深度、运动和视觉 cues 生成时序一致伪标签,是视频无监督场景理解的重要扩展

主要贡献

中高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。