通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-06-17 图像表征 · VFM · JEPA · 视频预训练
arXiv 新增 + frozen VFM routing / dense transfer · P1 · 2026-06-17

Task-Instructed Causal Routing of Vision:它和通用视觉自监督的关系在于:把多个 frozen VFMs 当专家,用任务指令和 counterfactual loss 做 token-level 路由

中高相关;详见方法、贡献和实验边界。

编号2606.15765 优先级P1 类别arXiv 新增 + frozen VFM routing / dense transfer 会议arXiv 新增 + frozen VFM routing / dense transfer 方法把多个 frozen VFMs 当专家,用任务指令和 counterfactual loss 做 token-level 路由 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:把多个 frozen VFMs 当专家,用任务指令和 counterfactual loss 做 token-level 路由。 中高相关;详见方法、贡献和实验边界。
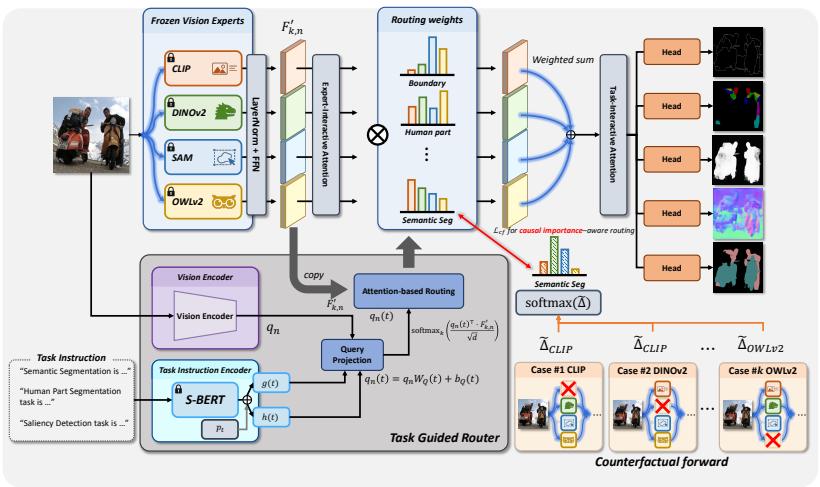
Figureure 2 · : Overview of TIGER
Figureure 2 · : Overview of TIGERFig. 2: Overview of TIGER. Frozen vision experts provide heterogeneous features that are fused through instruction-guided expert routing. Task-conditioned queries, interaction attention layers, and a shared decoder collectively produce task-specific dense predictions.这张图概括 Task-Instructed Causal Routing of Vision 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。
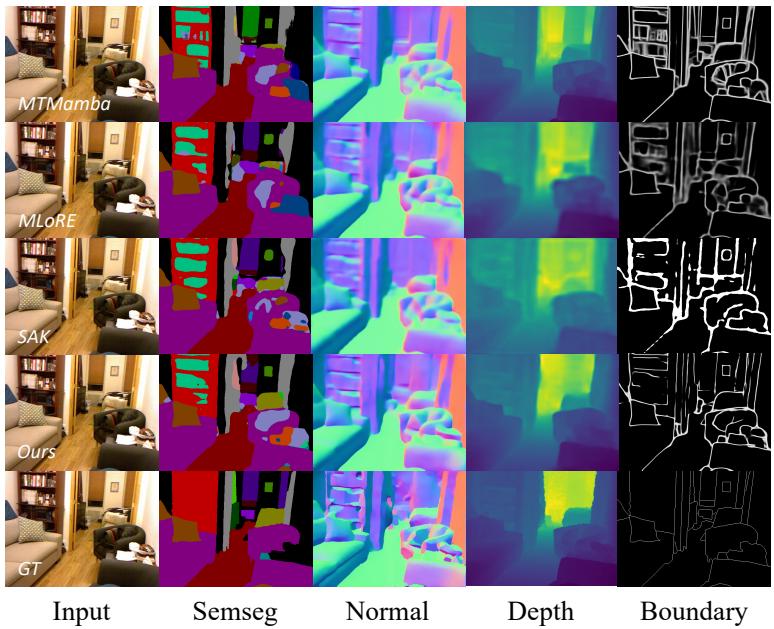
Figureure 4 · : Qualitative comparison on the NYUD-v2 dataset
Figureure 4 · : Qualitative comparison on the NYUD-v2 datasetFig. 4: Qualitative comparison on the NYUD-v2 dataset. Across all tasks, TIGER better preserves structural details and object contours, demonstrating stronger multitask consistency.这张图/表用于判断 Task-Instructed Causal Routing of Vision 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。

核心问题

它和通用视觉自监督的关系在于:把多个 frozen VFMs 当专家,用任务指令和 counterfactual loss 做 token-level 路由。

方法拆解

把多个 frozen VFMs 当专家,用任务指令和 counterfactual loss 做 token-level 路由

主要贡献

中高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。