LOCUS:它和通用视觉自监督的关系在于:训练时用局部 crop cue 教 MLLM 找回 full image 支持区域,改善细粒度证据选择
中相关;详见方法、贡献和实验边界。
LOCUS: Local Visual Cue Search for Enhancing Fine-Grained Perception in Multimodal Large Language Models arXiv 新增 + MLLM local cue self-improvement 原文链接
编号2606.16586优先级P3类别arXiv 新增 + MLLM local cue self-improvement会议arXiv 新增 + MLLM local cue self-improvement方法训练时用局部 crop cue 教 MLLM 找回 full image 支持区域,改善细粒度证据选择来源arXiv / OpenReview
先说结论。它和通用视觉自监督的关系在于:训练时用局部 crop cue 教 MLLM 找回 full image 支持区域,改善细粒度证据选择。 中相关;详见方法、贡献和实验边界。
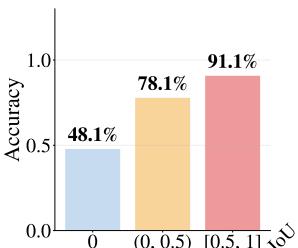
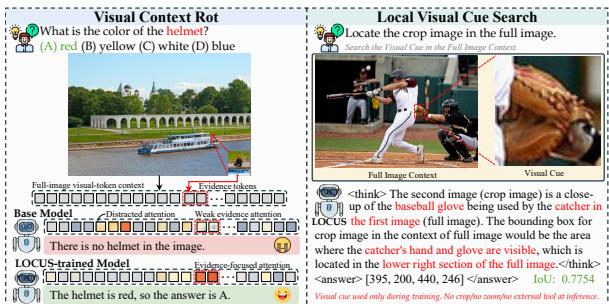
(b) VQA Accuracy by IoU Level Figure 2: Grounding quality vs(b) VQA Accuracy by IoU Level Figure 2: Grounding quality vs. VQA correctness on V\*Bench direct\_attributes with Qwen2.5-VL-7B-Instruct. (a) Mean IoU and success rate (IoU ≥ 0.5) for correct vs. wrong answers. (b) VQA accuracy by grounding IoU.这张图/表用于判断 LOCUS 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。Figureure 1 · : Motivation of LOCUSFigure 1: Motivation of LOCUS. Left: fine-grained evidence occupies only a few visual tokens and is weakly attended by the base model, causing visual context rot. Right: LOCUS uses training-time local visual cue search to improve evidence selection while keeping inference unchanged.这张图来自论文 PDF 的结构化抽取。当前用于辅助理解 LOCUS 的方法或实验,请结合正文精读段落一起看。
核心问题
它和通用视觉自监督的关系在于:训练时用局部 crop cue 教 MLLM 找回 full image 支持区域,改善细粒度证据选择。
方法拆解
训练时用局部 crop cue 教 MLLM 找回 full image 支持区域,改善细粒度证据选择