通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-06-20 图像表征 · VFM · JEPA · 视频预训练
arXiv 新增 + ICML 2026 + object-centric SSL · P0 · 2026-06-20

3D-DLP:它和通用视觉自监督的关系在于:用自监督重建把 RGB-D/voxel 场景分解成 3D latent particles,是今天最直接的通用视觉表征学习论文

高相关;详见方法、贡献和实验边界。

编号2606.19451 优先级P0 类别arXiv 新增 + ICML 2026 + object-centric SSL 会议arXiv 新增 + ICML 2026 + object-centric SSL 方法用自监督重建把 RGB-D/voxel 场景分解成 3D latent particles,是今天最直接的通用视觉表征学习论文 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:用自监督重建把 RGB-D/voxel 场景分解成 3D latent particles,是今天最直接的通用视觉表征学习论文。 高相关;详见方法、贡献和实验边界。
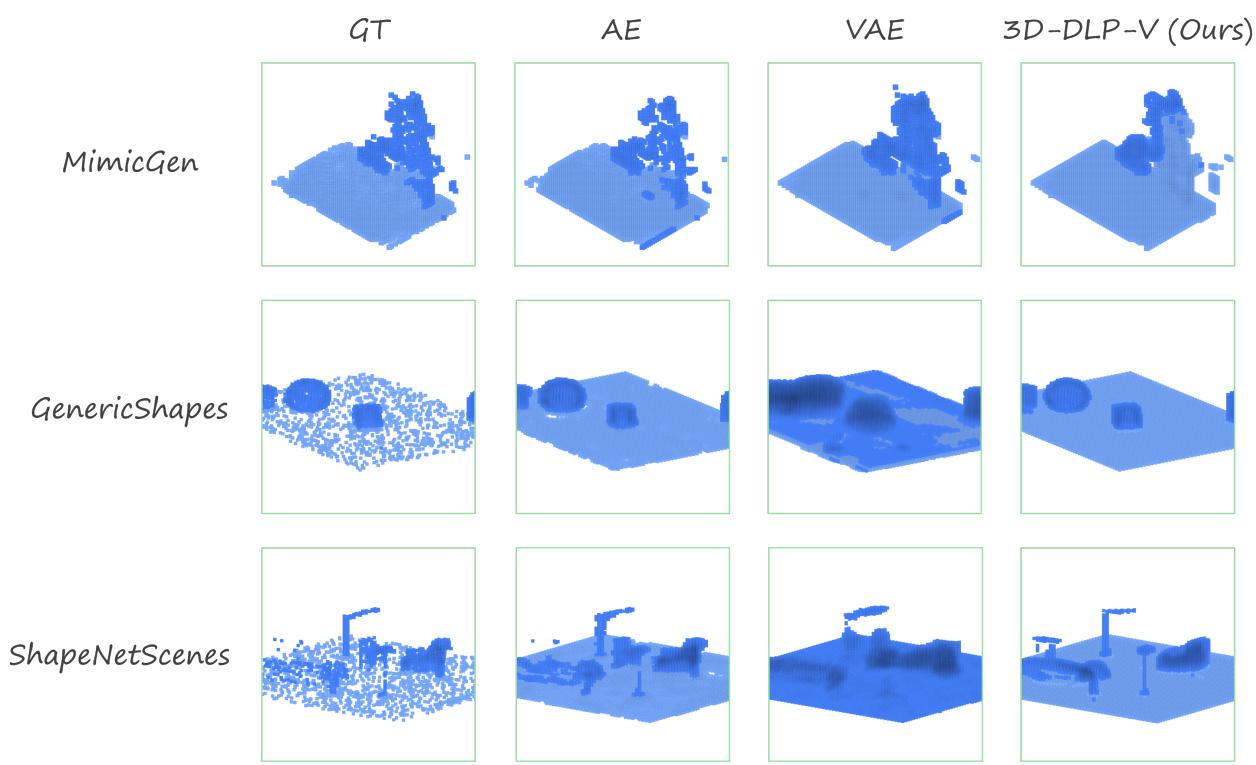
Figureure 15 · Occupancy Voxels Scene Reconstruction Comparison
Figureure 15 · Occupancy Voxels Scene Reconstruction ComparisonFigure 15. Occupancy Voxels Scene Reconstruction Comparison. Reconstruction of input occupancy voxels from various datasets. AE-Autoencoder, VAE-Variational autoencoder.这张图/表用于判断 3D-DLP 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
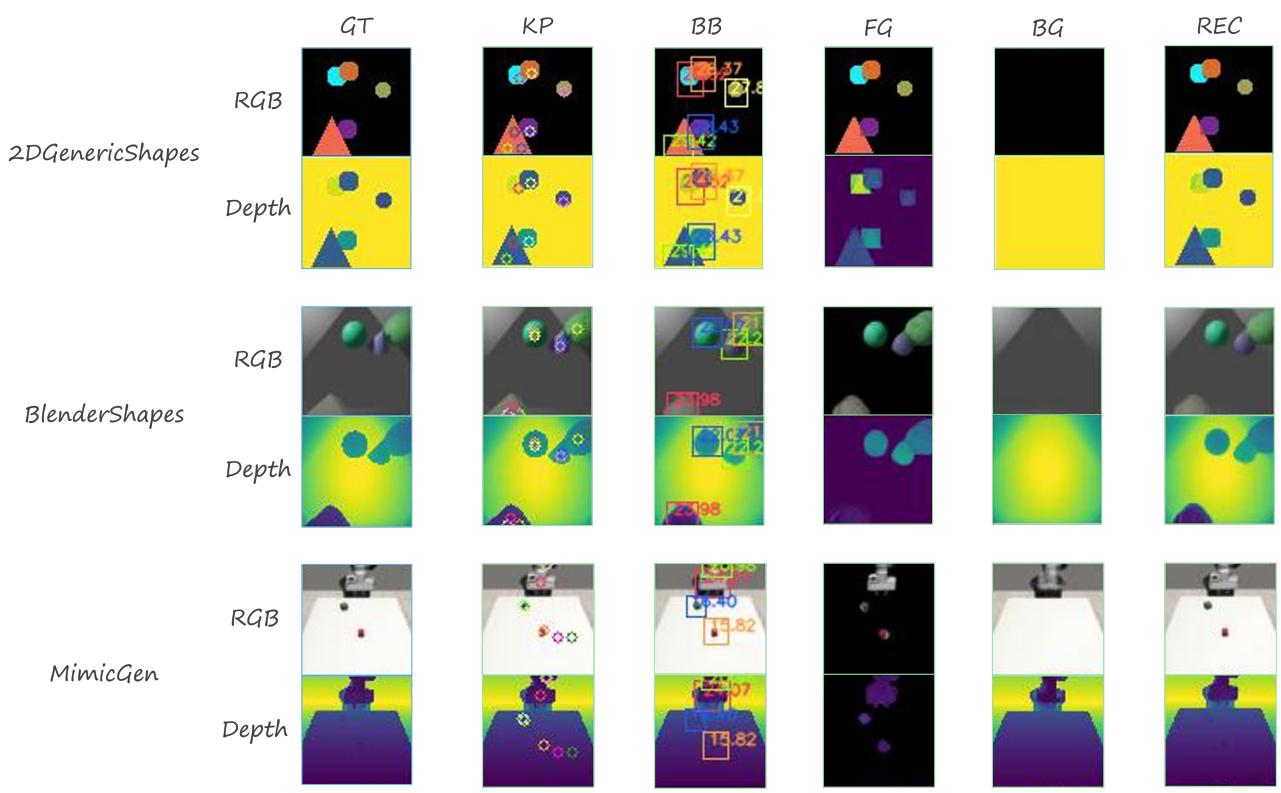
Figureure 13 · 3D-DLP-D Scene Decomposition
Figureure 13 · 3D-DLP-D Scene DecompositionFigure 13. 3D-DLP-D Scene Decomposition. 3D-DLP-D extends 2D DLP by learning latent particles jointly from RGB and depth images. It models appearance features separately for color and depth channels, while explicit attributes such as keypoints and bounding boxes are learned jointly across all channels.这张图来自论文 PDF 的结构化抽取。当前用于辅助理解 3D-DLP 的方法或实验,请结合正文精读段落一起看。

核心问题

它和通用视觉自监督的关系在于:用自监督重建把 RGB-D/voxel 场景分解成 3D latent particles,是今天最直接的通用视觉表征学习论文。

方法拆解

用自监督重建把 RGB-D/voxel 场景分解成 3D latent particles,是今天最直接的通用视觉表征学习论文

主要贡献

高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。