SpatialSV:它和通用视觉自监督的关系在于:把 MLLM 的 2D visual features 主动 lift 到深度、位姿、点云等显式 3D 表示
中高相关;详见方法、贡献和实验边界。
SpatialSV: Internalizing Interpretable 3D Spatial Awareness in MLLMs via Task-Oriented Visual Supervision arXiv 新增 + IJCAI 2026 + 3D visual supervision 原文链接
编号2606.19915优先级P1类别arXiv 新增 + IJCAI 2026 + 3D visual supervision会议arXiv 新增 + IJCAI 2026 + 3D visual supervision方法把 MLLM 的 2D visual features 主动 lift 到深度、位姿、点云等显式 3D 表示来源arXiv / OpenReview
先说结论。它和通用视觉自监督的关系在于:把 MLLM 的 2D visual features 主动 lift 到深度、位姿、点云等显式 3D 表示。 中高相关;详见方法、贡献和实验边界。
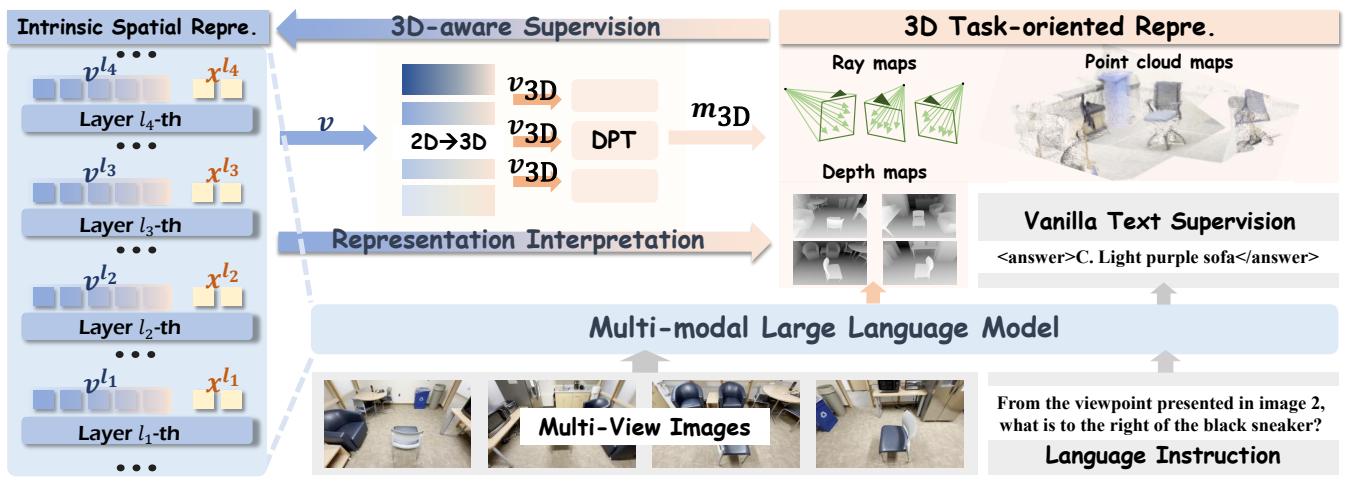
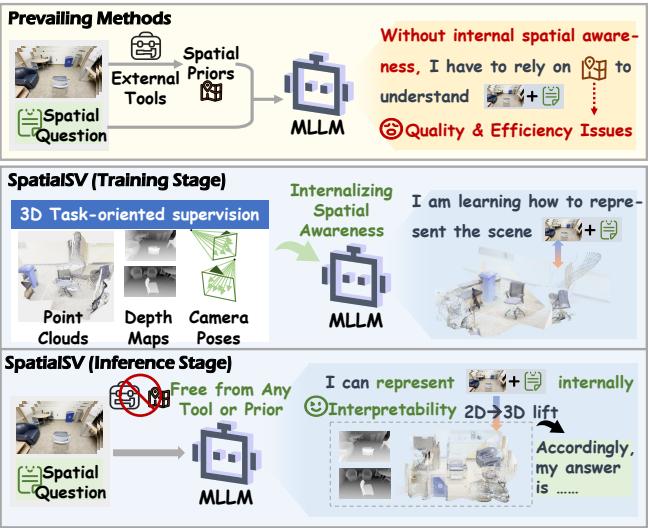
Figureure 3 · : The schematic illustration of SpatialSV, a framework that internalizFigure 3: The schematic illustration of SpatialSV, a framework that internalizes interpretable and robust 3D spatial awareness in MLLMs via task-oriented visual supervision. We perform 2D-to-3D lifting of the MLLM’s multi-layer hidden visual features and align them with explict 3D representations, including depth maps, ray maps, and point clouds. In this way, SpatialSV facilitates robust spatial representation learning and offers representation interpretability.这张图概括 SpatialSV 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。Figureure 1 · : (a) Prevailing methods incorporate external spatial priors as input Figure 1: (a) Prevailing methods incorporate external spatial priors as input to MLLMs, suffering from prior quality and inference efficiency issues. (b) SpatialSV internalizes 3D spatial awareness in MLLMs via task-oriented visual supervision, which enables spatial understanding with interpretable intrinsic spatial representations.这张图/表用于判断 SpatialSV 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
核心问题
它和通用视觉自监督的关系在于:把 MLLM 的 2D visual features 主动 lift 到深度、位姿、点云等显式 3D 表示。
方法拆解
把 MLLM 的 2D visual features 主动 lift 到深度、位姿、点云等显式 3D 表示