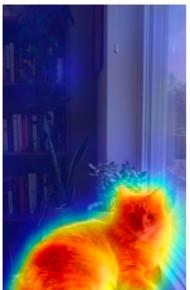
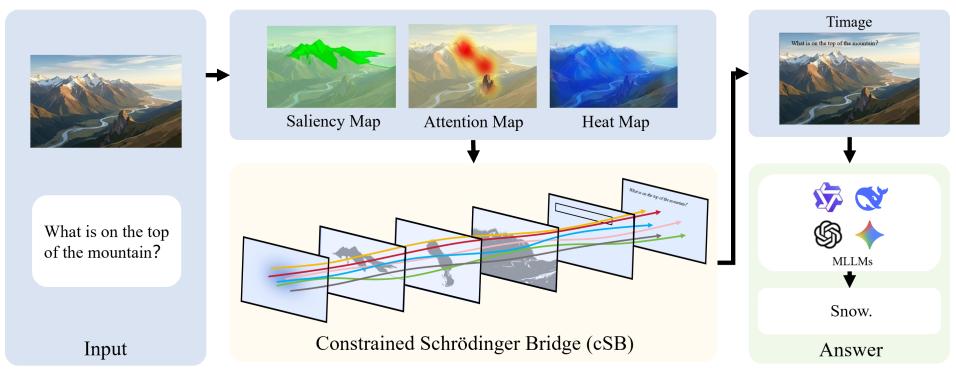
A:Cat FigA:Cat Fig. 3. Qualitative comparison showing the benefit of Timage. Left: random question embedding covers irrelevant content and misleads the model to “Book”. Right: cSB renders a semantically grounded, non-occluding overlay that preserves foreground saliency and guides attention to the window region, yielding the correct “Cat”.这张图/表用于判断 Timage 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。Figureure 2 · Overview of TimageFig. 2. Overview of Timage. From an image and its question we build a feasible manifold Ω through an Admissible Mask that merges semantic relevance with a hard non-occlusion prior. A Constrained Schr¨odinger Bridge then renders the inlaid text via a projected stochastic process, guaranteeing both geometric validity and downstream accuracy.这张图概括 Timage 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。