arXiv 新增 · 2D VFM to 3D representation · P2 · 2026-06-24
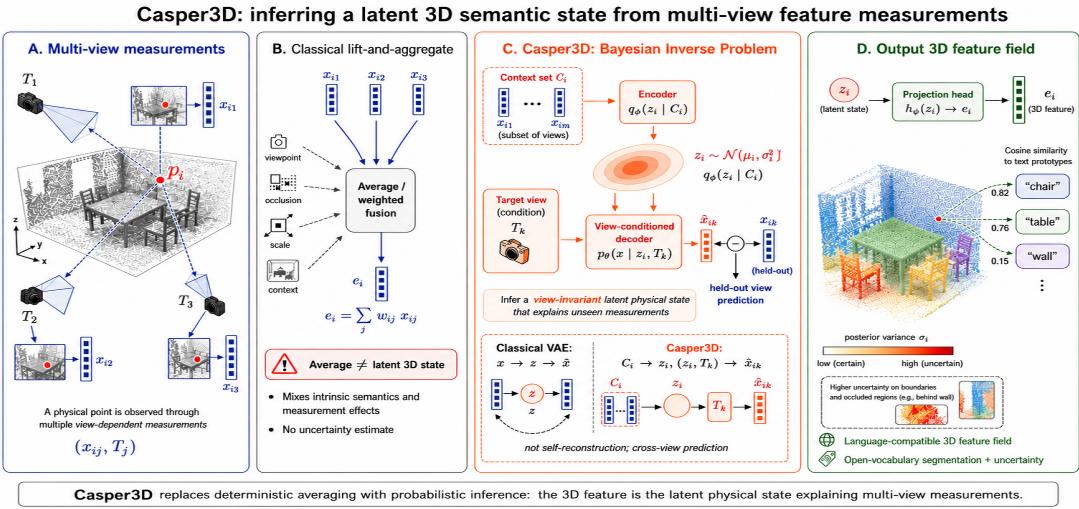
Lightweight 3D Feature Pretraining by:它和通用视觉自监督的关系在于:把 2D foundation embeddings 反演成 3D semantic latent,方法对 self-supervised embeddings 兼容
中相关;详见方法、贡献和实验边界。
编号2606.21292
优先级P2
类别arXiv 新增 · 2D VFM to 3D representation
会议arXiv 新增 · 2D VFM to 3D representation
方法把 2D foundation embeddings 反演成 3D semantic latent,方法对 self-supervised embeddings 兼容
来源arXiv / OpenReview
先说结论。它和通用视觉自监督的关系在于:把 2D foundation embeddings 反演成 3D semantic latent,方法对 self-supervised embeddings 兼容。 中相关;详见方法、贡献和实验边界。
核心问题
它和通用视觉自监督的关系在于:把 2D foundation embeddings 反演成 3D semantic latent,方法对 self-supervised embeddings 兼容。
方法拆解
把 2D foundation embeddings 反演成 3D semantic latent,方法对 self-supervised embeddings 兼容
主要贡献
中相关;详见方法、贡献和实验边界。
实验看点
实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。
局限与读法
这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。