通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-07-01 图像表征 · VFM · JEPA · 视频预训练
arXiv cross; unsupervised cross-modal retrieval · P3 · 2026-07-01

Unsupervised Data-Efficient Cross-Modal Retrieval with:它和通用视觉自监督的关系在于:少量 image-text pair 下,把 VLM 连续 latent 结构转成二值 Hamming 空间,适合看数据效率与跨模态对齐

中相关;详见方法、贡献和实验边界。

编号2606.31517 优先级P3 类别arXiv cross; unsupervised cross-modal retrieval 会议arXiv cross; unsupervised cross-modal retrieval 方法少量 image-text pair 下,把 VLM 连续 latent 结构转成二值 Hamming 空间,适合看数据效率与跨模态对齐 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:少量 image-text pair 下,把 VLM 连续 latent 结构转成二值 Hamming 空间,适合看数据效率与跨模态对齐。 中相关;详见方法、贡献和实验边界。

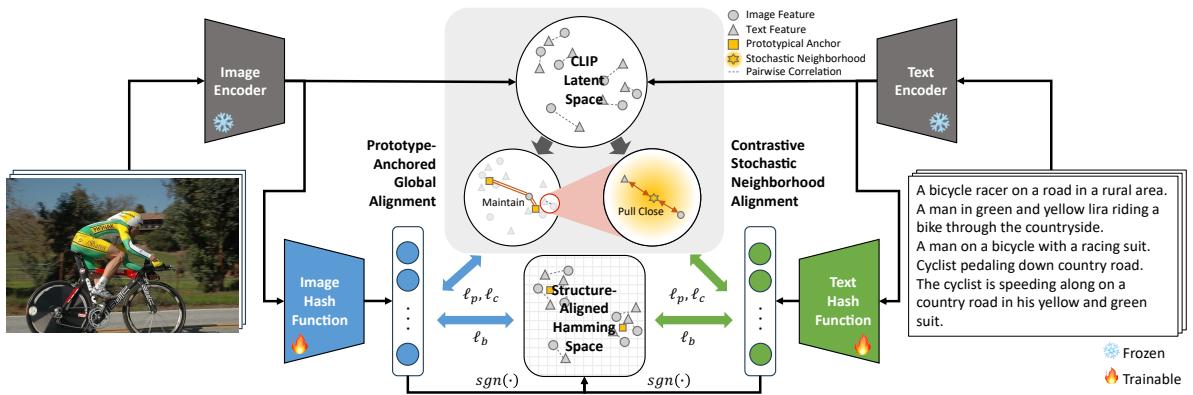
Figureure 1 · : Framework of GNAH
Figureure 1 · : Framework of GNAHFig. 1: Framework of GNAH. Image and text features from CLIP are mapped into a Hamming space via modality-specific hash functions. Structural information is preserved through Prototype-Anchored Global Alignment for global semantics and Contrastive Stochastic Neighborhood Alignment for local neighborhood priors.这张图概括 Unsupervised Data-Efficient Cross-Modal Retrieval with 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。
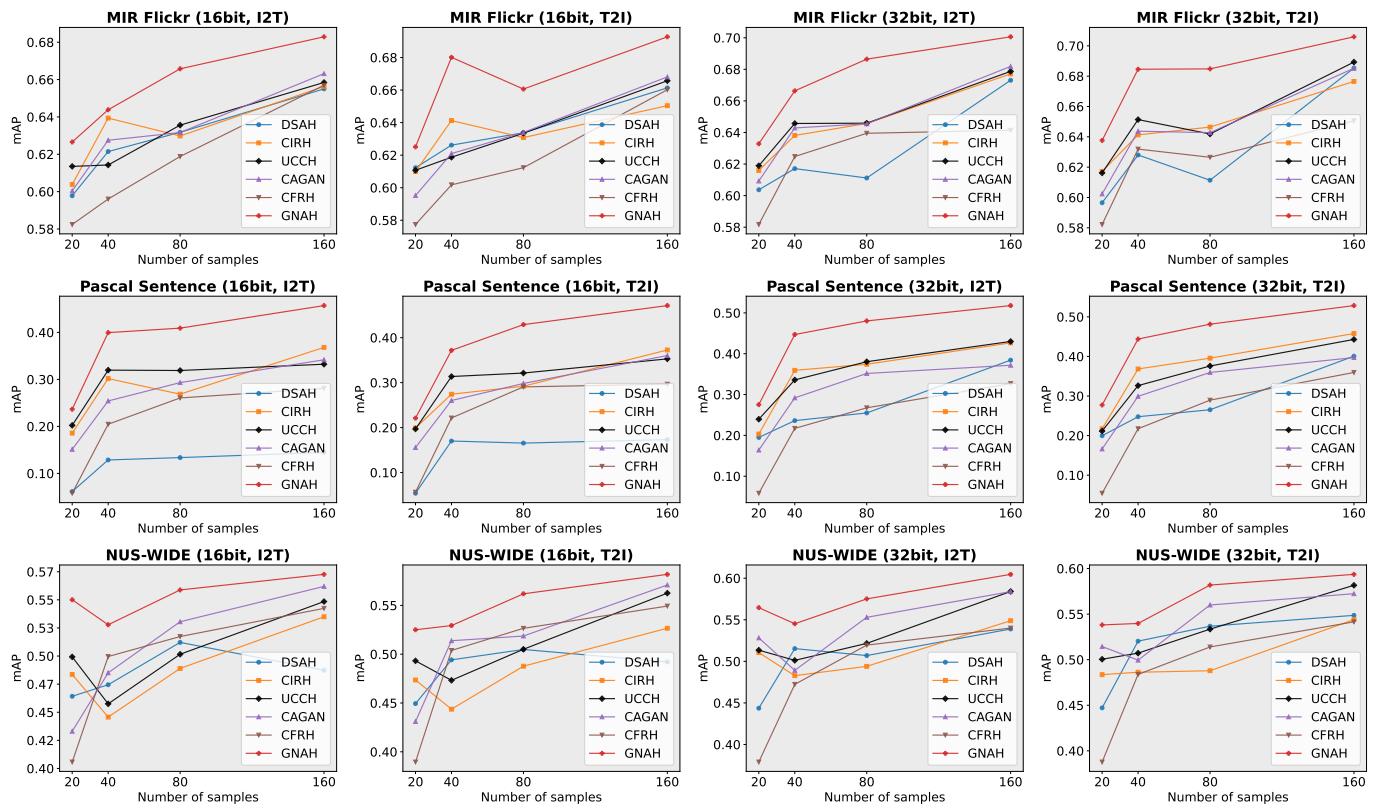
Figureure 2 · : Retrieval performance of unsupervised CMH methods through data-effic
Figureure 2 · : Retrieval performance of unsupervised CMH methods through data-efficFig. 2: Retrieval performance of unsupervised CMH methods through data-efficient learning at 16 and 32 bits. “I2T” denotes image-to-text retrieval and “T2I” denotes text-to-image retrieval.这张图/表用于判断 Unsupervised Data-Efficient Cross-Modal Retrieval with 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
核心问题

它和通用视觉自监督的关系在于:少量 image-text pair 下,把 VLM 连续 latent 结构转成二值 Hamming 空间,适合看数据效率与跨模态对齐。

方法拆解

少量 image-text pair 下,把 VLM 连续 latent 结构转成二值 Hamming 空间,适合看数据效率与跨模态对齐

主要贡献

中相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。