通用视觉自监督研究报
A Daily Digest of Visual Self-Supervised Learning
2026-07-01 图像表征 · VFM · JEPA · 视频预训练
arXiv new/cross; 3D masked autoencoder · P1 · 2026-07-01

Mitigating Positional Leakage in 3D:它和通用视觉自监督的关系在于:3D MAE 的 positional leakage 诊断对所有 masked reconstruction 类 SSL 都有警示价值

中高相关;详见方法、贡献和实验边界。

编号2606.31570 优先级P1 类别arXiv new/cross; 3D masked autoencoder 会议arXiv new/cross; 3D masked autoencoder 方法3D MAE 的 positional leakage 诊断对所有 masked reconstruction 类 SSL 都有警示价值 来源arXiv / OpenReview

先说结论。它和通用视觉自监督的关系在于:3D MAE 的 positional leakage 诊断对所有 masked reconstruction 类 SSL 都有警示价值。 中高相关;详见方法、贡献和实验边界。

(b) Fig
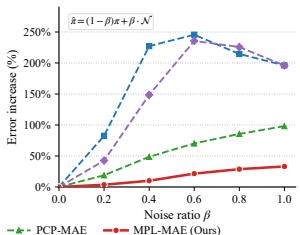
(b) Fig(b) Fig. 1: (a) Pipeline of MAE for 3D point cloud representation learning. (b) Empirical analysis of representative 3D MAE methods. Left: gradient ratio between positional embeddings (π) and encoder outputs (Z) during training. Right: sensitivity analysis of reconstruction error under perturbations applied to positional embeddings.这张图概括 Mitigating Positional Leakage in 3D 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。
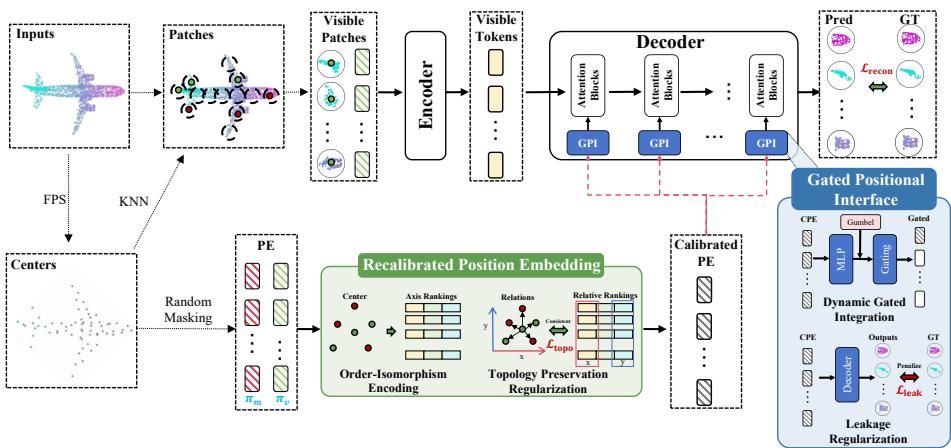
Figureure 2 · : Pipeline of MPL-MAE
Figureure 2 · : Pipeline of MPL-MAEFig. 2: Pipeline of MPL-MAE. The RPE module generates recalibrated positional embeddings for the decoder. A GPI module is inserted before each Transformer layer in the decoder to regulate positional injection, promoting balanced optimization and robust geometric feature learning.这张图概括 Mitigating Positional Leakage in 3D 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。
核心问题

它和通用视觉自监督的关系在于:3D MAE 的 positional leakage 诊断对所有 masked reconstruction 类 SSL 都有警示价值。

方法拆解

3D MAE 的 positional leakage 诊断对所有 masked reconstruction 类 SSL 都有警示价值

主要贡献

中高相关;详见方法、贡献和实验边界。

实验看点

实验部分建议重点看两类证据:一是作者是否把方法收益和更强数据、更长训练、更大模型区分开;二是跨模型、跨数据或跨任务迁移是否还能保留同样趋势。

局限与读法

这篇论文的结论需要结合任务设置、训练数据规模和消融实验一起看;不要只凭单个指标判断它对通用视觉表征的价值。