先说结论。它和通用视觉自监督的关系在于:把“输入 token 怎么切”提升为资源自适应第三杠杆,尤其指出 self-supervised foundation backbones 最受益。 高相关;详见方法、贡献和实验边界。
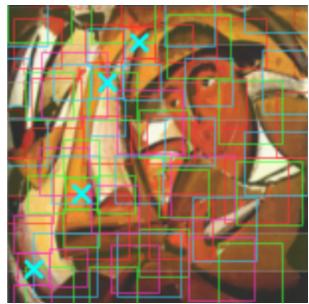
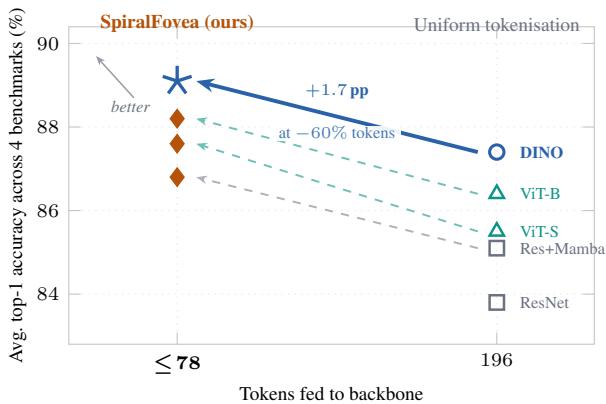
(b) Portrait(b) Portrait. Figure 1. Content-dependent tokenisation. Cyan × marks are entropy hotspot anchors; coloured boxes are multi-scale spiral patches. Anchors localise to the face/upper body; the dark, nearuniform background receives zero foveal tokens and is never processed by the backbone. Both images are 224×224.这张图来自论文 PDF 的结构化抽取。当前用于辅助理解 SpiralFovea 的方法或实验,请结合正文精读段落一起看。Figureure 3 · Quality–resource Pareto frontierFigure 3. Quality–resource Pareto frontier. Each arrow traces one backbone’s trajectory from uniform tokenisation (hollow markers, right) to SpiralFovea (filled markers, left). Every backbone moves up and to the left simultaneously — a strict Pareto improvement across the whole frontier. The DINO trajectory (solid blue) is the headline: +1.7 pp accuracy at −60% input tokens.这张图/表用于判断 SpiralFovea 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。
核心问题
它和通用视觉自监督的关系在于:把“输入 token 怎么切”提升为资源自适应第三杠杆,尤其指出 self-supervised foundation backbones 最受益。
方法拆解
把“输入 token 怎么切”提升为资源自适应第三杠杆,尤其指出 self-supervised foundation backbones 最受益