Audio-Visual Flamingo: Open Audio-Visual Intelligence for Long and Complex Videos arXiv cross; open long audio-visual MLLM 原文链接
编号2607.16107优先级P2类别arXiv cross; open long audio-visual MLLM会议arXiv cross; open long audio-visual MLLM方法开放长音视频数据、三阶段课程和时间戳 grounding CoT,适合看视频/音频/图像联合表征的工程化路线来源arXiv / OpenReview
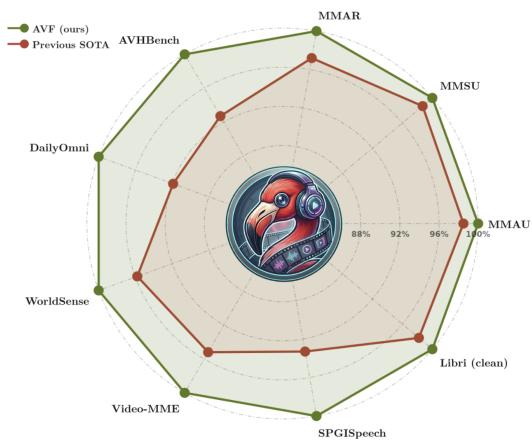
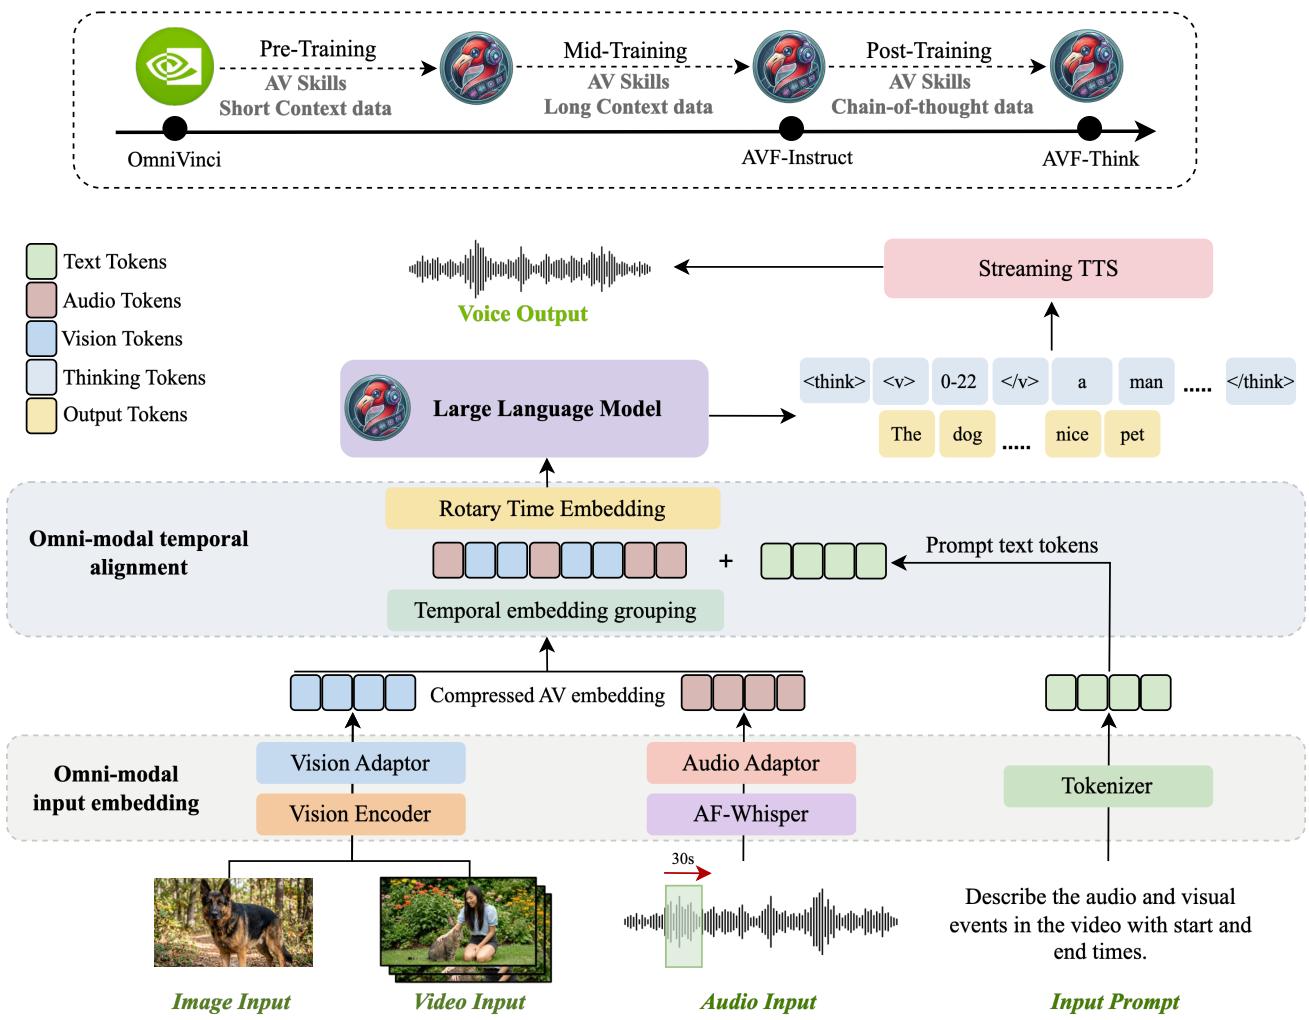
Figureure 1 · : Comparison of AVF with current SOTA model on various benchmarks.Figure 1: Comparison of AVF with current SOTA model on various benchmarks.这张图/表用于判断 Audio-Visual Flamingo 的实验收益来自哪里。重点看替换、消融或跨模型设置下趋势是否一致,而不是只看单个最高分。Figureure 2 · : AV-Flamingo training and architectureFigure 2: AV-Flamingo training and architecture. Top: Starting from OmniVinci, AV-Flamingo is trained in three stages: pre-training on AV-Skills short-context data, mid-training on AV-Skills long-context data, and post-training on chain-of-thought data, producing AVF-Instruct and AVF-Think. Bottom: AV-Flamingo accepts image, video, audio, and text inputs. Visual and audio streams are encoded through separate encoders and adaptors, compressed into audio-visual embeddings, temporally grouped, and aligned with prompt text tokens using Rotary Time Embedding before being processed by the LLM.这张图概括 Audio-Visual Flamingo 的整体方法流程。阅读时先看模块之间传递的训练信号,再看作者如何把目标拆成可优化的子问题。